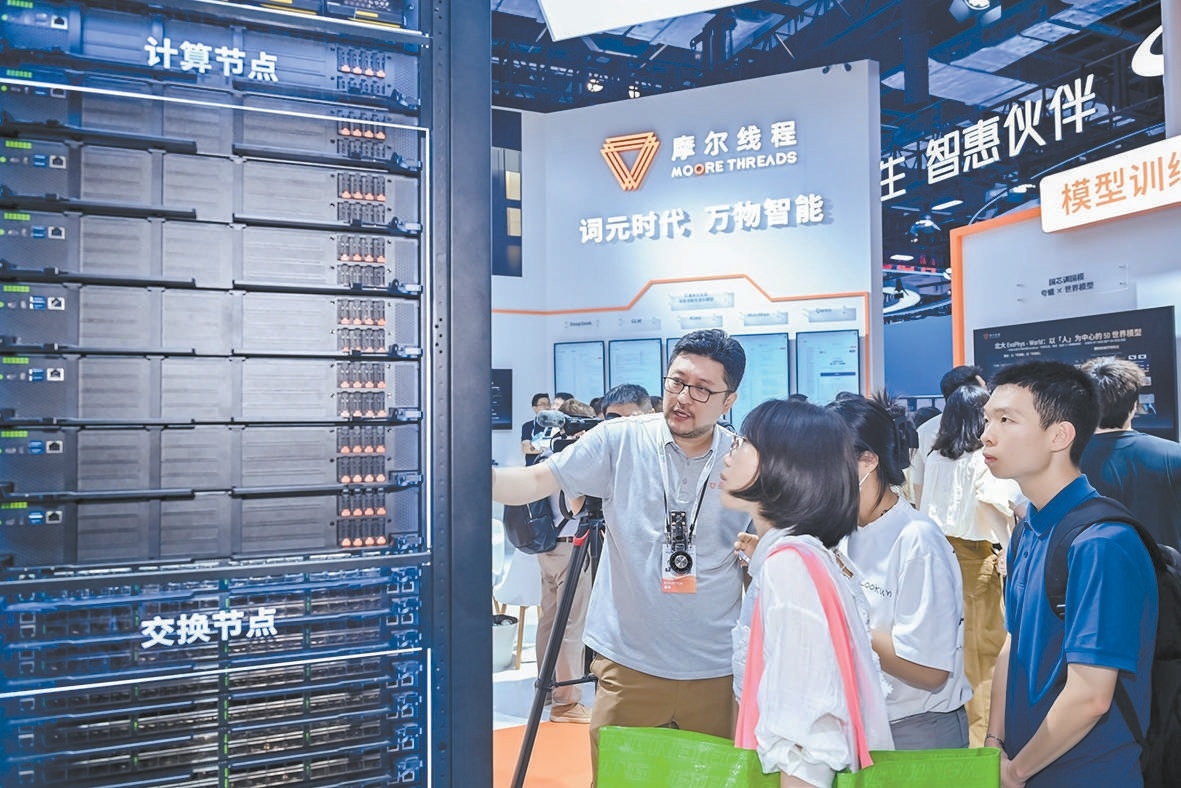
- 北京算力企业发布的超节点在世界人工智能大会期间吸引了参会者驻足。
人工智能(AI)时代,算力正成为新的核心生产力。当单颗芯片性能的提升路径日益收窄,国产算力正通过系统级架构创新,走出一条不同于传统追赶逻辑的突围之路。
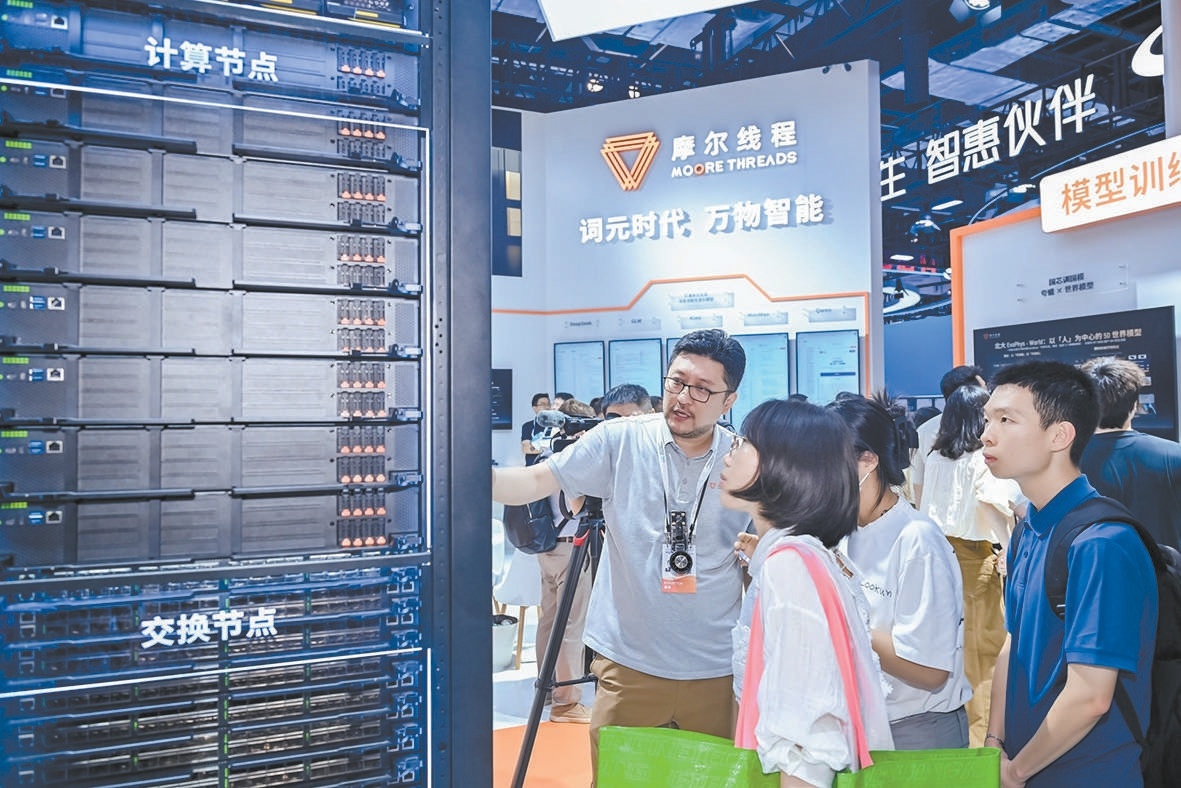
北京算力企业发布的超节点在世界人工智能大会期间吸引了参会者驻足。
破局
十万卡连成“一台计算机”
在万亿参数大模型的训练过程中,当算力开足马力,最大的“堵点”是什么?答案可能出乎你的意料:并不是计算本身,而是芯片之间的“传话”过程。
在近日举行的华为全联接大会上,全球首个采用NPO(近封装光学)技术的超节点——昇腾960超节点发布,试图突破这一困局。
所谓超节点,是指具备跨物理节点的统一内存编址能力,逻辑上具备“一台计算机”特征的计算系统。通俗而言,训练一个大模型,好比组织成千上万名工人同时建造一座大厦。过去芯片之间的协同,就像一群人隔着围墙传话,如果每个人各干各的、消息靠层层传递,大量时间就耗在了“等人传话”上。超节点,则相当于直接推倒围墙,搭建一条高速通道,让不同芯片能像“一台计算机”一般高效协同,从而解决超大模型数据的“堵车”难题。
华为副董事长、轮值董事长汪涛表示,当前,智能体已经可以按小时级连续工作,到2030年预计将以月为单位执行任务;中国推理词元已增长到每日500万亿左右,到2030年预计将达到百万万亿级。模型从回答问题走向持续处理复杂工作,对计算系统的规模、效率和可靠性均提出了更高要求。
同时,随着大模型参数规模持续增长,AI算力集群从千卡向万卡甚至十万卡扩展,决定AI算力实际产出的,正在从“单颗芯片峰值”转向“整套系统的协同效率”。
在这一趋势下,仅提高单颗芯片的计算能力已经难以覆盖整套系统的需求。如何降低大规模集群中的通信损耗,让更多理论算力真正转化为有效算力?超节点,成为AI基础设施竞争的新焦点。
汪涛表示,在10万张算力卡规模的集群中,如果仍采用传统的8卡服务器架构,内部通信时间可能超过训练总时间的40%——也就是说,近一半的算力都堵在了“传话”路上。华为马尔可夫实验室的仿真数据则显示,在相同的10万卡规模下,由4096卡超节点组成的集群,相比由8卡服务器组成的集群,MFU(模型浮点算力利用率)可以提升2.75倍。
“我们做过测算,MFU每提升1个百分点,10万亿参数大模型的训练可以缩短三天。”汪涛说。在模型竞争以周为单位计算的时代,这无疑是一笔无法用金钱衡量的“时间账”,很可能直接影响前沿大模型训练效率竞争的胜负。
共筑
国产算力生态加速形成
如果说早期的超节点还是个别厂商的探索,2026年,它已成为国产算力的集体动作。在两个月前举行的世界人工智能大会上,壁仞科技、沐曦股份、燧原科技、摩尔线程等国产厂商相继推出超节点产品。“超节点已成为产学研在AI基础设施领域的共识。”汪涛说。
共识之下,落地也开始提速。华为方面公布,昇腾系列超节点全球部署已突破1000套,服务国内AI企业、科研院所与各地算力中心,昇腾950超节点也迈入规模商用阶段。壁仞科技与上海仪电、曦智科技、中兴通讯联合发布商用版“光跃”光互连光交换GPU(图形处理器)超节点,已实现数千卡规模部署。阿里云则发布灵骏真武M890超节点实例,通过公共云对外提供超节点形态的算力服务,使得开发者和企业不用自建机房,也能用上超节点。
国产算力纷纷落地,也带来一个新问题:每家芯片厂商各有一套软件工具链,开发者如果换一家芯片平台,就得从头学一遍、重写一遍,开发适配成本极高。
能不能让开发者“写一次代码,跑遍所有国产芯片”?北京智源研究院牵头研发开源统一软件栈众智FlagOS,推动AI系统软件实现“一次开发、跨芯片运行、多框架支持”,其算子自动生成平台已支持英伟达、摩尔线程、华为、海光、天数等多种芯片。“各自为战”的国产算力,有了统一的软件底座,将有效降低行业对海外单一硬件体系的依赖。
随着国产算力生态加速形成,越来越多主流大模型主动选择在国产算力上“安家”。
今年4月,DeepSeek V4发布首日,摩尔线程、寒武纪等国产算力就实现了适配接入,其新一代模型已在昇腾上完成混合专家并行方案验证,在推理任务中实现1.5至1.73倍加速。智谱新推出的GLM-5.3 Flash模型,也首次采用国产芯片集群承接大规模线上推理服务。
“国芯跑国模”成为常态的同时,国产算力已不再局限于面向中国市场。汪涛表示,昇腾已覆盖90多个主流第三方社区,在全球最主流的AI开发框架之一PyTorch平台上,昇腾成为其官方支持的首个中国算力底座,全球开发者不用再经历繁琐的流程,就能直接通过PyTorch获取来自中国的昇腾算力。
展望
从“可用”到“好用”布局下一程
繁荣之下,短板不应被回避。
在词元消耗量巨大、使用成本高昂的同时,国内智算GPU利用率却不足30%,智算集群的电力需求也正在突破区域电网承载极限。
这些挑战的核心矛盾在于智能需求的持续膨胀,与算力效率、能源供给能力之间的结构性失衡。这也揭示了国产算力的另一面:算力不是简单的不够用,而是没用好。
中国工程院院士郑纬民直言,当前,中国AI算力基础设施正处于关键转型期,仍面临明显的结构性矛盾。一方面,国内高端智能算力供不应求,另一方面,国产中低端算力市场“供过于求”。
“在高端算力紧缺的当下,我们一方面要稳步推进国产替代和硬件扩容,另一方面必须依靠自主可控的基础软件来盘活现有的算力资源,把中低端的算力也高效利用起来。”郑纬民说。
从寄望于一颗“争气芯”单点超车,到用架构创新补单卡短板、用开源开放聚拢开发者、用大规模应用场景反复锤炼系统——国产算力的这条突围路并不轻松。好在,追赶与补课从未停止,被正视的短板,也恰恰孕育着机遇与下一程的方向。
针对算力中心利用率不足这一问题,中科创星人工智能组负责人王超分析,核心原因是部分老旧显卡、国产芯片尚未达到“好用”状态,推理性能仍有提升空间。“国产芯片已解决‘可用’问题,但与‘高性价比、好用’还有差距,这正是投资布局的机会。”目前,机构正围绕算力、存储、网络三大环节,关注算力芯片、推理策略、网络交换芯片及新兴数据中心建设,“未来国产算力不仅服务国内需求,出海也将成为重要方向。”(孙奇茹)